
Значимость и правила Википедии: источники, НТЗ и удаление
Разбираем, как проверяют компанию и персону, почему важны независимые источники, как устроены обсуждение удаления и запрос на восстановление
Википедия помогает нейросетям отвечать на вопросы о компаниях и людях. Но появление статьи еще не означает, что ChatGPT начнет рекомендовать бренд. Модель может найти страницу при поиске, знать часть сведений из обучения или выбрать другой источник. Проверьте, как ИИ описывает компанию и чем подтверждает ответ.
Вы спрашиваете: «Кто основал компанию N?» Нейросеть называет то же имя, что и Википедия. Кажется, источник найден. Но этот факт мог встретиться модели еще при обучении, попасть в ответ через поиск или оказаться в другой публикации. Даже похожая формулировка сама по себе не показывает, откуда взялись сведения.
Если рядом с ответом есть ссылка, откройте ее и найдите подтверждение. Правильное имя и подходящая на первый взгляд страница еще не означают, что цитата действительно объясняет ответ.
При обучении модель усваивает сведения из текстов. В поисковом режиме сервис находит страницы под конкретный вопрос. Графы знаний хранят связи между людьми, организациями и событиями; внешние системы могут использовать эти данные. Сравнение приведено в таблице.
Механизм | Как работает | Что видно пользователю | Что можно измерить | Чего нельзя утверждать |
Обучение | Модель усваивает закономерности из корпуса текстов | Ответ, иногда без ссылок | Точность и устойчивость фактов | Что конкретный факт взят из Википедии |
Поиск и RAG | Найденные материалы передаются модели как контекст | Цитаты и ссылки, если сервис их показывает | Наличие ссылки, соответствие ей ответа | Что процитированная страница входила в обучение |
Графы знаний | Внешняя система использует структурированные связи | Сведения о сущности; источник может не раскрываться | Согласованность доступных данных | Что конкретная модель обязательно обращалась к Wikidata |
Англоязычная Википедия входила в обучающие данные GPT-3. С тех пор многое изменилось, и эти данные неактуальны для нынешних моделей. RAG устроен иначе: сервис находит материалы и передает их нейросети для подготовки ответа.
Wikidata хранит сведения об организациях и людях в форме, удобной для программ. Это отдельный проект, и наличие записи не означает, что модель обязательно ее прочитает. У Рувики и Циклопедии могут быть другие показатели: исследования Википедии их не описывают.

Цифры в исследованиях различаются, потому что авторы задают разные вопросы и по-разному считают ссылки. Одни выясняют, в скольких ответах появилась Википедия, другие считают все цитирования. Перед сравнением нужно проверить, какую метрику использовал исследователь.
Исследование и период | Выборка | Метрика и результат |
Suff Digital, сбор 23.09.2026 | 25 940 ответов на 2 984 общих вопроса; запросы из США | Ответы хотя бы с одной ссылкой на Википедию: ChatGPT — 2,7%, Perplexity — 23,1%, Google AI Overviews — 19,4% |
Sorank, август 2025 — октябрь 2026 | 498 158 ответов; коммерческие вопросы, преимущественно на французском; вызовы через API | Цитирования на 100 ответов: 2,12 суммарно, 5,40 для ChatGPT. Это не процент ответов со ссылкой |
Huang et al., Answer Bubbles, публикация в октябре 2026 | 11 000 реальных запросов; пять систем, включая обычный Google | Анализ выбора и использования источников: Википедия непропорционально часто представлена в текстах ответов |
У Suff Digital ответ со ссылкой учитывается один раз. У Sorank Википедия может получить несколько цитирований в одном ответе, если подтверждает сведения о разных рекомендованных компаниях. Кроме того, справка об основателе и вопрос о выборе поставщика требуют разных источников. Это еще одна причина, почему показатели разнятся.
Эти работы показывают, как системы выбирают источники. Из них нельзя вывести, насколько чаще конкретную компанию будут рекомендовать после появления статьи. Для русскоязычного бренда нужна проверка на своих вопросах.
В статье о компании обычно собраны базовые сведения: название, сфера деятельности, основатель, история. Нейросеть может использовать их для справки о бренде. Если сайт, независимые публикации и энциклопедия согласуются между собой, описание проще проверить. А противоречия требуют внимания: ИИ может перепутать одноименные организации или приписать компании чужой проект.
Допустим, имя основателя и год основания компании N совпадают на сайте, в независимой публикации и Википедии. Эти сведения подходят для справки о бренде. Оценку качества продукта нужно подтверждать отдельно: верная дата основания ничего о нем не говорит.Когда вы оцениваете результат, считайте отдельно упоминания бренда, ссылки на источники и переходы на сайт. Первые два показателя видны в ответах, третий проверяют в веб-аналитике. Ссылка на Википедию не ведет читателя сразу на сайт компании. А для управления репутацией нужно еще понять, что именно о ней сказано и насколько это верно.
«Видимость бренда стоит оценивать по тому, что нейросеть о нём рассказывает. Одного упоминания мало: проверьте, верны ли факты, не перепутаны ли компании и куда ведут ссылки. Статья в Википедии может дать ответу справочную основу, но репутационная работа на этом не заканчивается. Ошибки в других источниках тоже нужно находить и исправлять».
Юлия Мосцевая, исполнительный директор и руководитель отдела репутационного маркетинга ВАЛС
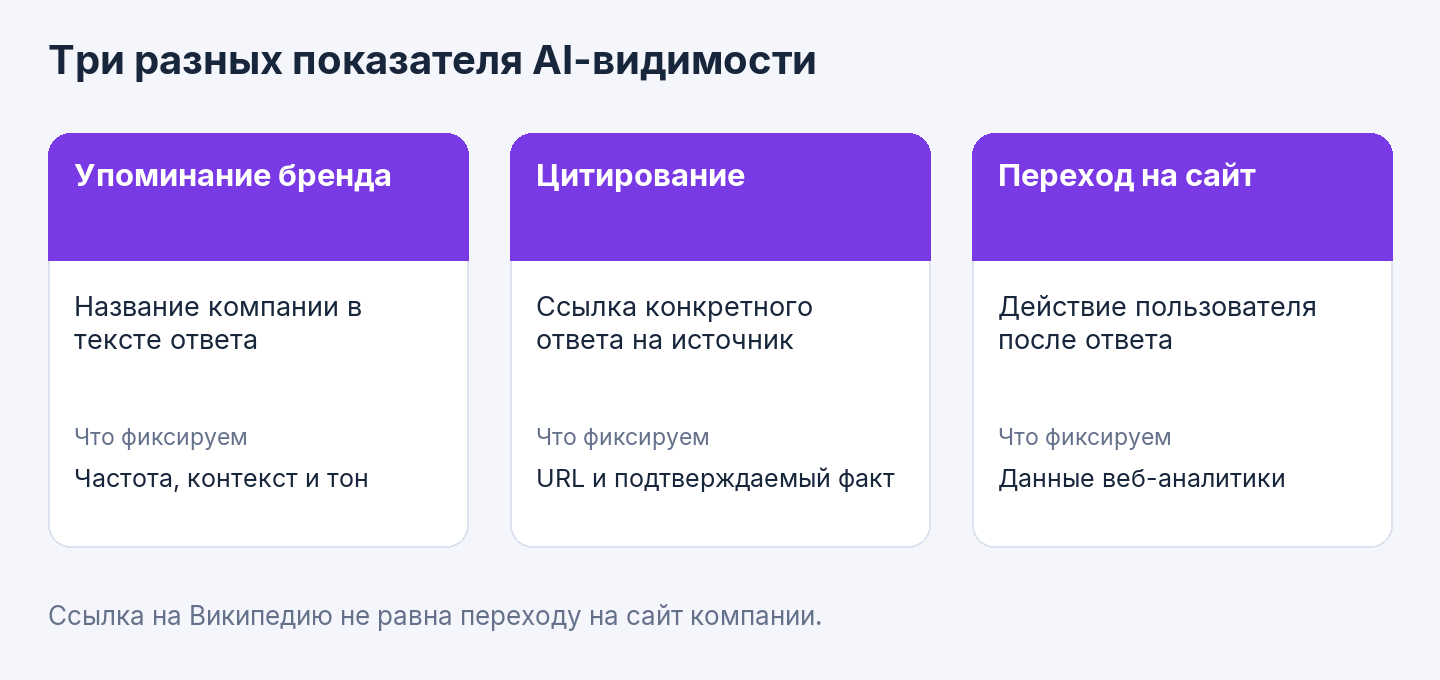
Упоминание, цитирование и переход не следует объединять в один показатель успеха.
Статья может существовать годами, а нейросеть все равно выберет другой источник. Вопрос о дате основания и просьба посоветовать подрядчика требуют разной информации. Кроме того, ChatGPT, Perplexity и Google ищут и показывают материалы по-своему. Одна удачная проверка еще не означает, что бренд будет появляться в ответах постоянно.
При проверке учитывайте пять факторов:
Работает ли сервис с поиском или отвечает по знаниям модели? Учитывайте также версию продукта.
Что спрашивает пользователь: историю компании, сведения о продукте или совет по выбору?
Успел ли источник обновиться? Например, в нем может оставаться имя прежнего руководителя.
Есть ли другие подходящие материалы: официальный сайт, реестр, отраслевая публикация?
Совпадают ли язык, регион и дата проверок? Без этого результаты сложнее сравнивать.
Есть и редакционная граница. По правилам Википедии статья должна опираться на независимые источники и сохранять нейтральность. Заинтересованность нужно раскрывать. Заказчик не получает право управлять страницей или убирать из нее все, что ему не нравится.
Задайте нейтральные вопросы о компании нескольким системам. Сохраните ответы и ссылки, затем повторите тест. Сравните факты, ошибки и выбранные источники. Так проверяют описание по названию бренда. Для оценки рекомендаций без его названия нужен отдельный набор запросов.
Начните с 12 вопросов. О самой компании: что это за организация, чем занимается, где находится и какие продукты выпускает. Об истории: когда появилась, кто ее основал, меняла ли название и какие источники описывают ее прошлое. О людях и деятельности: кто руководит, что известно об основателе, чем компания известна и с какими проектами связана. В каждом вопросе указывайте точное название; при необходимости уточняйте, о какой организации речь.
Выберите хотя бы три системы, например ChatGPT с поиском, Perplexity и Google AI Overviews. Если Google не показал AI-блок, так и запишите: обычная выдача его не заменяет.
Повторите запросы в новых диалогах и в разные даты. Используйте одинаковые вопросы, язык, регион и режим. Записывайте название модели, если сервис его показывает.
Откройте ссылки и проверьте, подтверждают ли они сказанное. Страница должна относиться к вашей компании, а не к организации с похожим названием. Сверьте факты с надежными публикациями.
Записывайте отдельно точность, тон ответа, упоминание бренда и ссылки. Если сервис недоступен, отмечайте пропуск: считать это отсутствием бренда в ответе нельзя.
Вопрос | Модель | Дата | Ответ | Цитата | Совпадение с Википедией | Вывод |
Кто основал компанию N? | Система, версия, режим | Дата теста | Полный текст или файл | Фрагмент и URL | Совпало / различается | Источник подтвержден / не установлен |
В документации веб-поиска API OpenAI видимые цитаты отделены от полного списка источников. Сервис может показать не все материалы, с которыми работал. Поэтому отсутствие ссылки на Википедию еще не означает, что ее не использовали.
Проверяйте репутацию в ИИ-выдаче вместе с результатами обычного поиска: что нейросеть говорит о компании и какие страницы находит человек.
Если нейросеть ошиблась, сначала сохраните ответ и откройте ссылки. Неточность могла прийти из старой публикации, повторяться на нескольких сайтах или появиться при подготовке ответа. Если указанная страница не подтверждает утверждение, исправлять ее ради этого ответа не нужно.
Дальше проверьте сведения на сайте компании, в независимых публикациях, Википедии и Wikidata:
Найдите подтверждение верного факта в реестре, документе или надежной публикации.
Посмотрите, где повторяется ошибка. Если установить ее источник не удалось, не приписывайте его Википедии по догадке.
Исправьте сведения на своих ресурсах. Если неточность есть в чужой публикации, напишите редакции и приложите доказательства.
Предложите правку в Википедии по ее правилам и раскройте связь с компанией. Данные Wikidata проверьте отдельно.
Задайте прежние вопросы еще раз. Сравнивайте факты и ссылки: новый текст сам по себе не означает, что ошибка исчезла.
Изменения могут появиться в ответах не сразу. Поиску нужно обработать новую версию страницы. А если модель отвечает без поиска, свежая правка не обновит ее знания. После исправления все равно нужна повторная проверка.
Проверьте, достаточно ли о компании написали независимые источники и есть ли основания для статьи. Если страница уже существует, начните с фактов и ссылок. После обоснованных правок отслеживайте ответы ИИ. Решения сообщества Википедии и выбор источников нейросетью коммерческая команда не контролирует.
Если над статьей работает оплачиваемый специалист, связь с заказчиком нужно раскрыть. У компании также нет оснований требовать только положительного описания: подтвержденная критика может остаться в статье.
Обратитесь в ВАЛС Диджитал: мы поможем оценить перспективы статьи в Википедии и выстроить GEO-продвижение на проверяемой фактуре.
Да, ChatGPT может найти и использовать ее страницу при поиске. Википедия входила и в обучающие данные GPT-3, но современные модели базируются не только на этой информации.
Он может отвечать без поиска, выбрать другую страницу или показать не все источники. По отсутствию ссылки нельзя точно установить, использовалась ли Википедия.
Статья может стать источником для ответа о компании. Но нейросеть сама выбирает материалы под вопрос, поэтому обещать упоминания, ссылки или рекомендации нельзя.
Зависит от задачи. На сайте вы обновляете сведения и рассказываете о продуктах, в Википедии нужны нейтральное описание и независимые источники. Начинайте с того, где не хватает фактов или есть ошибки.
В Wikidata сведения о людях и организациях записаны в форме, удобной для программ. Внешние системы могут их использовать, но конкретный ответ ИИ сам по себе этого не доказывает.
Разбираем, как проверяют компанию и персону, почему важны независимые источники, как устроены обсуждение удаления и запрос на восстановление
Разбираем критерии значимости человека, требования к источникам, структуру биографии и причины удаления страниц о руководителях, экспертах, музыкантах и деятелях культуры.
Разбираем, как попасть в Википедию бизнесу или персоне и почему это сложнее, чем кажется. Объясняем, по каким критериям модераторы принимают статьи, как работает Инкубатор Википедии и какие требования важно учитывать для успешного размещения.
Опишите вашу ситуацию — эксперт бесплатно оценит её и предложит решение в течение 15 минут
Заполните форму — ответим в течение 15 минут